Cerebras Cloud ofrece inferencia alojada para modelos de lenguaje de pesos abiertos mediante una API de chat completions. Puedes probarla en Cloud Console o conectarla a una aplicación Python con el SDK de Cerebras o un cliente compatible con OpenAI. La precisión importante es que “gratis” significa actualmente una prueba limitada en el tiempo, no una asignación que se renueva para siempre: la documentación de Cerebras indica que las cuentas nuevas reciben $5 en créditos de prueba tras añadir un método de pago verificado, y que esos créditos vencen a los 30 días. Consulta las condiciones en Cerebras Cloud antes de planificar un proyecto.
Crear una clave y enviar una solicitud
Crea una cuenta en cloud.cerebras.ai, abre API Keys y genera una clave para tu proyecto. Trátala como una contraseña: guárdala en el servidor o en tu máquina de desarrollo, no la añadas a Git ni la incluyas en JavaScript del navegador o en una aplicación móvil. Si queda expuesta, revócala y crea otra.
Define la clave en el entorno del proceso:
export CEREBRAS_API_KEY="tu-clave-api"
Instala el SDK oficial de Python y envía una solicitud usando el identificador Shared Inference actual qwen-3.8-27b:
python -m pip install --upgrade cerebras_cloud_sdk
import os
from cerebras.cloud.sdk import Cerebras

client = Cerebras(api_key=os.environ["CEREBRAS_API_KEY"])
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[
        {"role": "system", "content": "Responde de forma clara y concisa."},
        {"role": "user", "content": "Explica qué hace un límite de solicitudes de API."},
    ],
    max_completion_tokens=300,
)
print(response.choices[0].message.content)
max_completion_tokens limita la salida, pero no obliga al modelo a usar todos esos tokens. Ajustarlo a la respuesta que necesitas evita reservar cuota innecesariamente. Consulta la guía rápida y el catálogo de modelos.
Usar la API compatible con OpenAI
Si tu aplicación ya utiliza el SDK Python de OpenAI, cambia la URL base, la clave y el identificador del modelo:
python -m pip install --upgrade openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CEREBRAS_API_KEY"],
    base_url="https://api.cerebras.ai/v1",
)
response = client.chat.completions.create(
    model="gpt-oss-120b",
    messages=[{"role": "user", "content": "Escribe una función breve de Python que limite un valor."}],
    max_completion_tokens=300,
)
print(response.choices[0].message.content)
El endpoint es https://api.cerebras.ai/v1/chat/completions; la autenticación utiliza Authorization: Bearer <API key>. La compatibilidad cubre usos comunes, no garantiza que cada parámetro funcione igual que en OpenAI. Revisa las notas de compatibilidad.
Contexto, salida y cuotas
La ventana de contexto abarca los tokens de entrada y de salida generada, sujeta a las restricciones del modelo y el proveedor. El máximo de completado limita por separado la salida de una respuesta. Ninguno equivale a las solicitudes por minuto o al límite diario.
Cerebras mide solicitudes y tokens. La documentación general distingue tokens totales (incluyen tokens en caché y sin caché) y tokens no almacenados en caché (que requieren procesamiento completo). Cualquiera de estos límites o el límite de solicitudes puede causar 429 Too Many Requests. Los valores dependen del modelo, la cuenta y el proyecto. Consulta Limits en Cloud Console; la página pública de límites ofrece valores generales que pueden no coincidir con los tuyos.
La siguiente tabla reproduce los valores del panel de la cuenta del autor, capturado el 17 de octubre de 2026. Son una instantánea específica, no una promesa para todas las cuentas.
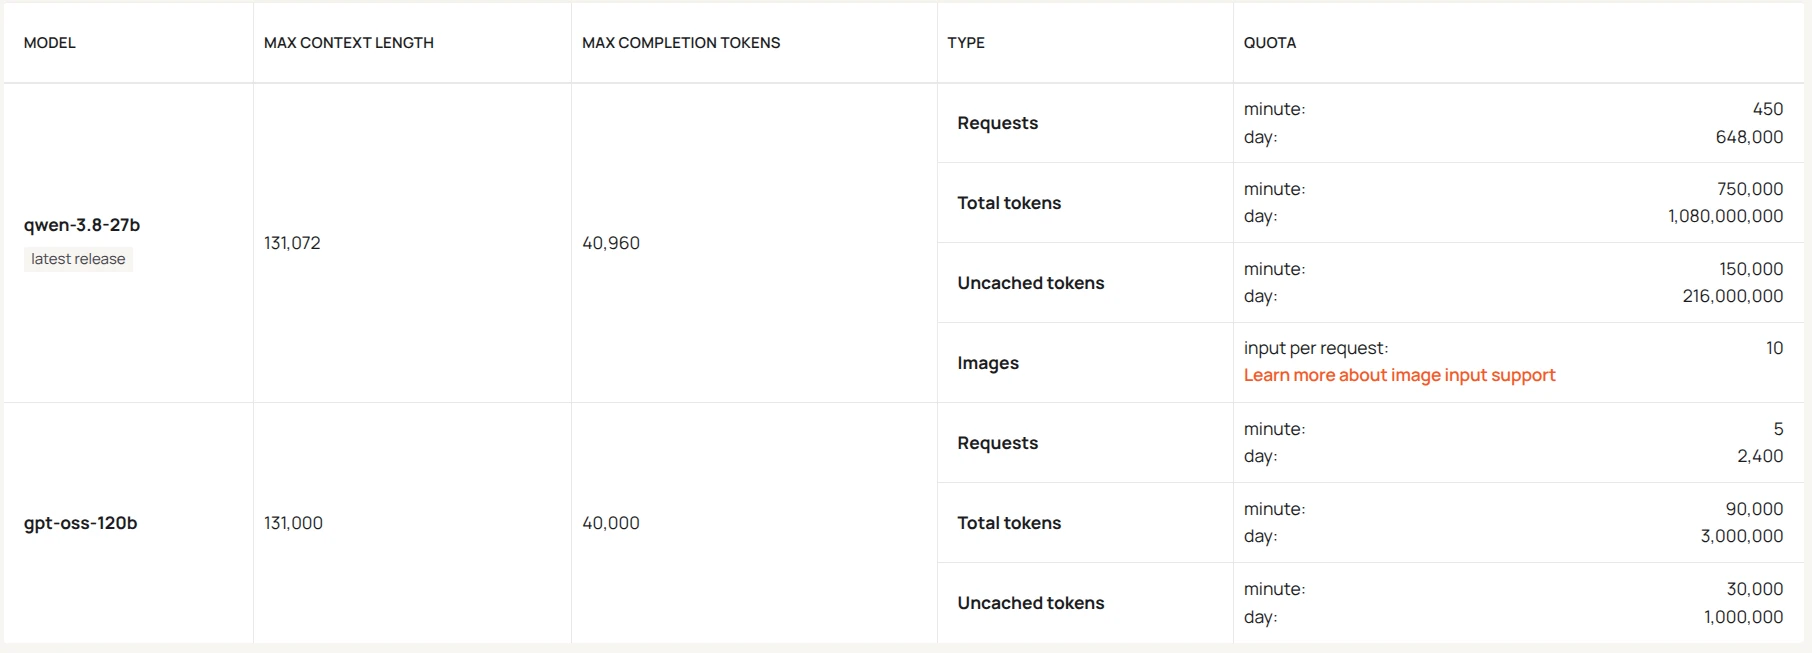
| Límite | qwen-3.8-27b (último lanzamiento) |
gpt-oss-120b |
|---|---|---|
| Contexto máximo | 131,072 | 131,000 |
| Tokens máximos de completado | 40,960 | 40,000 |
| Solicitudes por minuto | 450 | 5 |
| Solicitudes por día | 648,000 | 2,400 |
| Tokens totales por minuto | 750,000 | 90,000 |
| Tokens totales por día | 1,080,000,000 | 3,000,000 |
| Tokens no almacenados en caché por minuto | 150,000 | 30,000 |
| Tokens no almacenados en caché por día | 216,000,000 | 1,000,000 |
| Entrada de imágenes por solicitud | 10 | No aparece en la captura |
La captura no enumera una cuota de imágenes para gpt-oss-120b, así que no se infiere ninguna. “No aparece en la captura” no significa cero, ilimitado ni incompatible; comprueba los límites del modelo y del proyecto en tu propia consola. Para Qwen se muestran 10 imágenes por solicitud. La documentación pública actual indica otros límites para la prueba gratuita; por ejemplo, 5 solicitudes por minuto y 30K tokens no almacenados por minuto para ambos modelos. También pueden aplicarse límites de proyecto.
La prueba gratuita pública está limitada por crédito y tiempo, no se renueva indefinidamente. La documentación actual indica que las cuentas nuevas reciben $5 de créditos tras añadir un método de pago verificado; los créditos vencen después de 30 días. No supongas que los valores de la captura son permanentes.
Caché y conteo de tokens
La caché de prompts puede reutilizar cálculos para prefijos coincidentes, como instrucciones del sistema y definiciones de herramientas. Los aciertos pueden reducir el procesamiento y no cuentan en la cuota de tokens no almacenados, pero sí en la cuota independiente de tokens totales. No significa que los tokens en caché sean gratis o ilimitados. Mantén idéntico el comienzo reutilizable del prompt para favorecer aciertos. Más información en la guía de caché de prompts.
Comparar los modelos
| Métrica | Qwen3.8 27B (Xhigh) | gpt-oss-120b (High) |
|---|---|---|
| Artificial Analysis Intelligence Index | 34 | 12 |
| Velocidad de salida de la página del modelo | 41.3 tokens/segundo | 214.1 tokens/segundo |
| Ventana de contexto de la página del modelo | 256k | 131k |
| Modalidad | Entrada de texto, imagen y vídeo; salida de texto | Entrada y salida de texto |
| Parámetros totales / activos | 27B / no indicado | 117B / 5.1B |
| Licencia | Apache 2.0 | Apache 2.0 |
Son datos independientes para las configuraciones citadas, no garantías sobre el endpoint exacto de una cuenta. La velocidad de Qwen y su tiempo de 3.99 segundos hasta el primer token se basan en la API de Alibaba. El tiempo de 0.86 segundos de gpt-oss-120b se basa en la mediana entre proveedores. En una prueba de proveedor separada, Artificial Analysis informa para Cerebras con gpt-oss-120b 1,737.4 tokens de salida por segundo y 1.57 segundos hasta el primer token de respuesta. Esos resultados no garantizan el rendimiento de tu cuenta. La comparación actual de proveedores para Qwen no incluye Cerebras. Consulta las páginas de Qwen, gpt-oss-120b y el benchmark de proveedor.
El Intelligence Index es una puntuación compuesta, no un porcentaje ni un puntaje de CI. El 34 de Qwen es una estimación para la configuración Xhigh. La versión, el nivel de razonamiento, el proveedor y el servicio pueden cambiar los resultados. Los tokens internos de razonamiento también consumen presupuesto de salida. Artificial Analysis mide modelos en varias evaluaciones; la puntuación no predice por sí sola el resultado de tu tarea.
Recomendaciones y errores
- Para experimentos de mayor volumen con las cuotas de la captura, empieza por Qwen y limita razonablemente el tamaño del prompt y la salida.
- Para programación, razonamiento y automatización, prueba ambos con las mismas tareas. Qwen obtiene una puntuación más alta en la evaluación Xhigh, pero
gpt-oss-120bgenera más rápido en las cifras citadas. Evalúa el éxito y los tokens consumidos, no solo la velocidad. - Para lotes, divide el trabajo en segmentos reanudables y respeta el límite más estricto entre solicitudes y tokens. Reduce concurrencia y usa reintentos con espera gradual ante
429. - Qwen admite entrada de imágenes en Shared Inference según la documentación, actualmente en vista previa. Comprueba los límites de imágenes y carga de tu proyecto. No atribuyas soporte de imagen a
gpt-oss-120b.
Un 401 suele indicar que falta la clave o es inválida; un 404 puede indicar un identificador de modelo incorrecto o no disponible; un 429 señala un límite excedido. Revisa el error, reduce la concurrencia o max_completion_tokens y vuelve a intentarlo con una espera. Supervisa el uso en Cloud Console. Guarda claves en variables de entorno o un gestor de secretos, nunca en código del cliente ni en registros de solicitudes.
Recomendación final
Para empezar con las cuotas mostradas aquí, Qwen es la opción razonable para experimentar con más volumen porque las cuotas de la captura son mayores y admite imágenes. Prueba gpt-oss-120b si buscas una alternativa de texto más rápida o quieres comparar su comportamiento en tareas específicas. Usa un conjunto pequeño de evaluación y revisa de nuevo Cloud Console antes de basarte en cualquier cuota para un proyecto mayor.