Cerebras Cloud héberge l’inférence de modèles de langage à poids ouverts via une API de complétion de chat. Vous pouvez l’essayer dans la console Cloud ou la connecter à une application Python avec le SDK Cerebras ou un client compatible avec OpenAI. La nuance importante est que « gratuit » signifie actuellement un essai limité dans le temps, et non un quota qui se renouvelle indéfiniment : la documentation Cerebras indique que les nouveaux comptes reçoivent 5 $ de crédits d’essai après l’ajout d’un moyen de paiement vérifié, et que ces crédits expirent après 30 jours. Consultez les conditions de Cerebras Cloud avant de planifier un projet.
Créer une clé API et envoyer une requête
Créez un compte sur cloud.cerebras.ai, ouvrez API Keys et générez une clé pour votre projet. Traitez-la comme un mot de passe : conservez-la sur le serveur ou la machine de développement, ne la commitez pas dans Git et ne l’intégrez pas au JavaScript du navigateur ni à une application mobile. Si elle est exposée, révoquez-la et créez-en une nouvelle.
Définissez la clé dans l’environnement du processus :
export CEREBRAS_API_KEY="votre-cle-api"
Installez le SDK Python officiel et envoyez une requête avec l’identifiant Shared Inference actuel qwen-3.8-27b :
python -m pip install --upgrade cerebras_cloud_sdk
import os
from cerebras.cloud.sdk import Cerebras

client = Cerebras(api_key=os.environ["CEREBRAS_API_KEY"])
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[
        {"role": "system", "content": "Réponds clairement et brièvement."},
        {"role": "user", "content": "Explique le rôle d’une limite de requêtes API."},
    ],
    max_completion_tokens=300,
)
print(response.choices[0].message.content)
max_completion_tokens plafonne la sortie ; le modèle n’utilise pas nécessairement tous ces jetons. Une limite adaptée à la réponse voulue évite de réserver trop de quota. Consultez le guide de démarrage et le catalogue de modèles.
Utiliser l’API compatible avec OpenAI
Si votre application utilise déjà le SDK Python d’OpenAI, configurez l’URL de base Cerebras, la clé correspondante et l’identifiant exact du modèle :
python -m pip install --upgrade openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CEREBRAS_API_KEY"],
    base_url="https://api.cerebras.ai/v1",
)
response = client.chat.completions.create(
    model="gpt-oss-120b",
    messages=[{"role": "user", "content": "Écris une courte fonction Python qui borne une valeur."}],
    max_completion_tokens=300,
)
print(response.choices[0].message.content)
Le point d’accès est https://api.cerebras.ai/v1/chat/completions ; l’authentification utilise Authorization: Bearer <clé API>. La compatibilité couvre des usages courants, mais ne garantit pas un comportement identique pour chaque paramètre. Consultez les notes de compatibilité.
Comprendre le contexte et les quotas
La fenêtre de contexte couvre les jetons d’entrée et de sortie, sous réserve des limites du modèle et du fournisseur. Le maximum de complétion plafonne séparément la sortie d’une réponse. Aucun de ces deux chiffres ne correspond aux requêtes par minute ou au quota quotidien.
Cerebras mesure les requêtes et les jetons. Sa documentation distingue les jetons totaux (usages mis en cache et non mis en cache) et les jetons non mis en cache (qui nécessitent le calcul complet). Chaque réserve, ainsi que la limite de requêtes, peut entraîner une erreur 429 Too Many Requests. Les limites dépendent du modèle, du compte et du projet. Consultez Limits dans la console Cloud ; la page publique des limites fournit des valeurs générales susceptibles de différer.
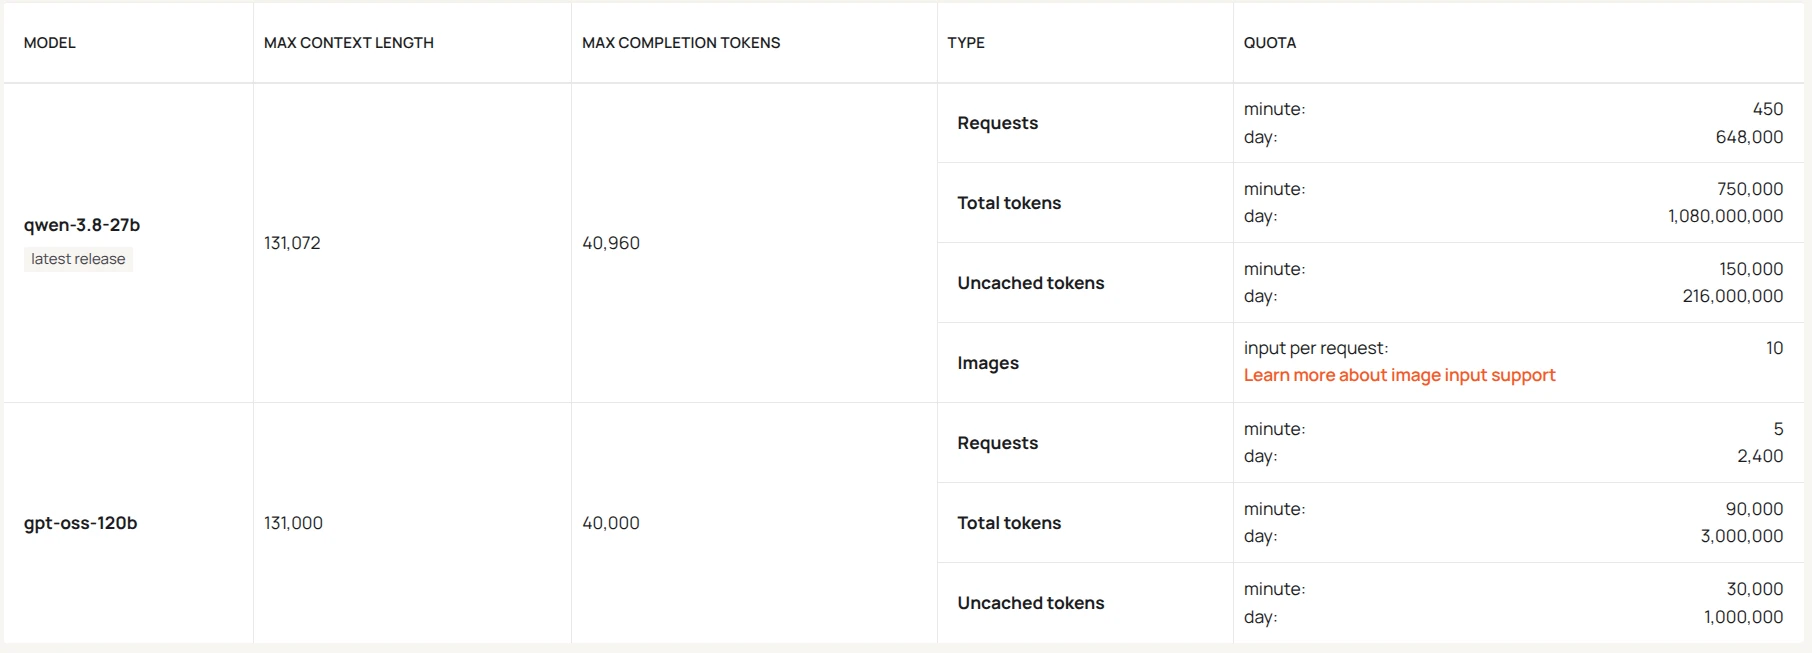
Le tableau ci-dessous reproduit les valeurs visibles dans la capture du compte de l’auteur, prise le 17 octobre 2026. Il s’agit d’un instantané de ce compte, pas d’une promesse pour tous les comptes.
| Limite | qwen-3.8-27b (dernière version) |
gpt-oss-120b |
|---|---|---|
| Contexte maximum | 131,072 | 131,000 |
| Jetons de complétion maximum | 40,960 | 40,000 |
| Requêtes par minute | 450 | 5 |
| Requêtes par jour | 648,000 | 2,400 |
| Jetons totaux par minute | 750,000 | 90,000 |
| Jetons totaux par jour | 1,080,000,000 | 3,000,000 |
| Jetons non mis en cache par minute | 150,000 | 30,000 |
| Jetons non mis en cache par jour | 216,000,000 | 1,000,000 |
| Entrée d’image par requête | 10 | Non indiqué dans la capture |
La capture ne donne aucun quota d’entrée d’image pour gpt-oss-120b ; nous n’en déduisons donc aucun. « Non indiqué dans la capture » ne signifie ni zéro, ni illimité, ni non pris en charge ; consultez les limites de votre modèle et de votre projet dans votre console. La capture indique 10 images par requête pour Qwen. La documentation publique actuelle affiche d’autres limites pour l’essai gratuit, par exemple 5 requêtes par minute et 30K jetons non mis en cache par minute pour chacun des deux modèles. Des limites de projet peuvent aussi s’appliquer.
L’essai gratuit public est limité par un crédit et dans le temps, et ne se renouvelle pas indéfiniment. La documentation indique actuellement 5 $ de crédits pour les nouveaux comptes après ajout d’un moyen de paiement vérifié ; ils expirent après 30 jours. Ne supposez pas que les valeurs de la capture sont permanentes.
Cache et comptage des jetons
Le cache des prompts peut réutiliser le calcul des préfixes identiques, par exemple les instructions système et définitions d’outils. Les correspondances peuvent réduire le traitement et ne comptent pas dans le quota de jetons non mis en cache, mais comptent dans celui des jetons totaux. Le cache ne signifie pas que les jetons sont gratuits ou illimités. Gardez identique le début réutilisable du prompt. Consultez le guide du cache de prompts.
Comparer les modèles
| Mesure | Qwen3.8 27B (Xhigh) | gpt-oss-120b (High) |
|---|---|---|
| Artificial Analysis Intelligence Index | 34 | 12 |
| Vitesse de sortie indiquée sur la page du modèle | 41.3 jetons/seconde | 214.1 jetons/seconde |
| Fenêtre de contexte indiquée | 256k | 131k |
| Modalité | Entrée texte, image et vidéo ; sortie texte | Entrée et sortie texte |
| Paramètres totaux / actifs | 27B / non indiqué | 117B / 5.1B |
| Licence | Apache 2.0 | Apache 2.0 |
Ce sont des données indépendantes pour les configurations citées, pas des garanties pour le point d’accès exact du compte. La vitesse Qwen et son délai de 3.99 secondes avant le premier jeton sont basés sur l’API Alibaba. Le délai de 0.86 seconde indiqué pour gpt-oss-120b repose sur la médiane de plusieurs fournisseurs. Dans un benchmark fournisseur distinct, Artificial Analysis mesure Cerebras sur gpt-oss-120b à 1,737.4 jetons de sortie par seconde et 1.57 seconde jusqu’au premier jeton de réponse. Ce ne sont pas des garanties de performance pour votre compte. La comparaison actuelle des fournisseurs pour Qwen ne répertorie pas Cerebras. Consultez les pages Qwen, gpt-oss-120b et le benchmark fournisseur.
L’Intelligence Index est un score composite, pas un pourcentage ni un score de QI. Le 34 de Qwen est une estimation pour la configuration de raisonnement Xhigh. La version, le niveau de raisonnement, le fournisseur et le service peuvent modifier les résultats. Les jetons de raisonnement consomment aussi le budget de sortie. Ce score ne prédit pas à lui seul le résultat d’une tâche particulière.
Conseils pratiques et erreurs
- Pour expérimenter avec un plus grand volume selon les quotas de la capture, commencez par Qwen et limitez la taille des prompts et des sorties.
- Pour le code, le raisonnement et l’automatisation, testez les deux modèles sur les mêmes tâches. Qwen obtient un score Xhigh plus élevé, mais
gpt-oss-120bgénère plus rapidement dans les chiffres cités. Mesurez la réussite de bout en bout et les jetons utilisés. - Pour les lots, divisez le travail en segments reprenables et respectez la limite la plus stricte entre requêtes et jetons. Réduisez la concurrence et utilisez un délai progressif après un
429. - La documentation indique l’entrée d’image de Qwen dans Shared Inference, actuellement en aperçu. Respectez les limites d’images et de charge utile du projet. N’attribuez pas la prise en charge des images à
gpt-oss-120b.
Une erreur 401 indique généralement une clé absente ou invalide ; un 404 peut signaler un identifiant de modèle incorrect ou indisponible ; un 429 signale une limite dépassée. Consultez l’erreur, réduisez la concurrence ou max_completion_tokens, puis réessayez avec un délai. Suivez votre consommation dans Cloud Console. Conservez les clés dans des variables d’environnement ou un gestionnaire de secrets, jamais dans le code client ou les journaux de requêtes.
Recommandation
Pour commencer avec les quotas présentés ici, Qwen constitue un choix raisonnable pour des essais répétés : les quotas de la capture sont plus élevés et le modèle accepte les images. Essayez gpt-oss-120b pour une alternative texte plus rapide ou pour comparer ses résultats sur des tâches précises. Constituez un petit jeu d’évaluation et consultez à nouveau Cloud Console avant de dépendre d’un quota pour un projet plus important.